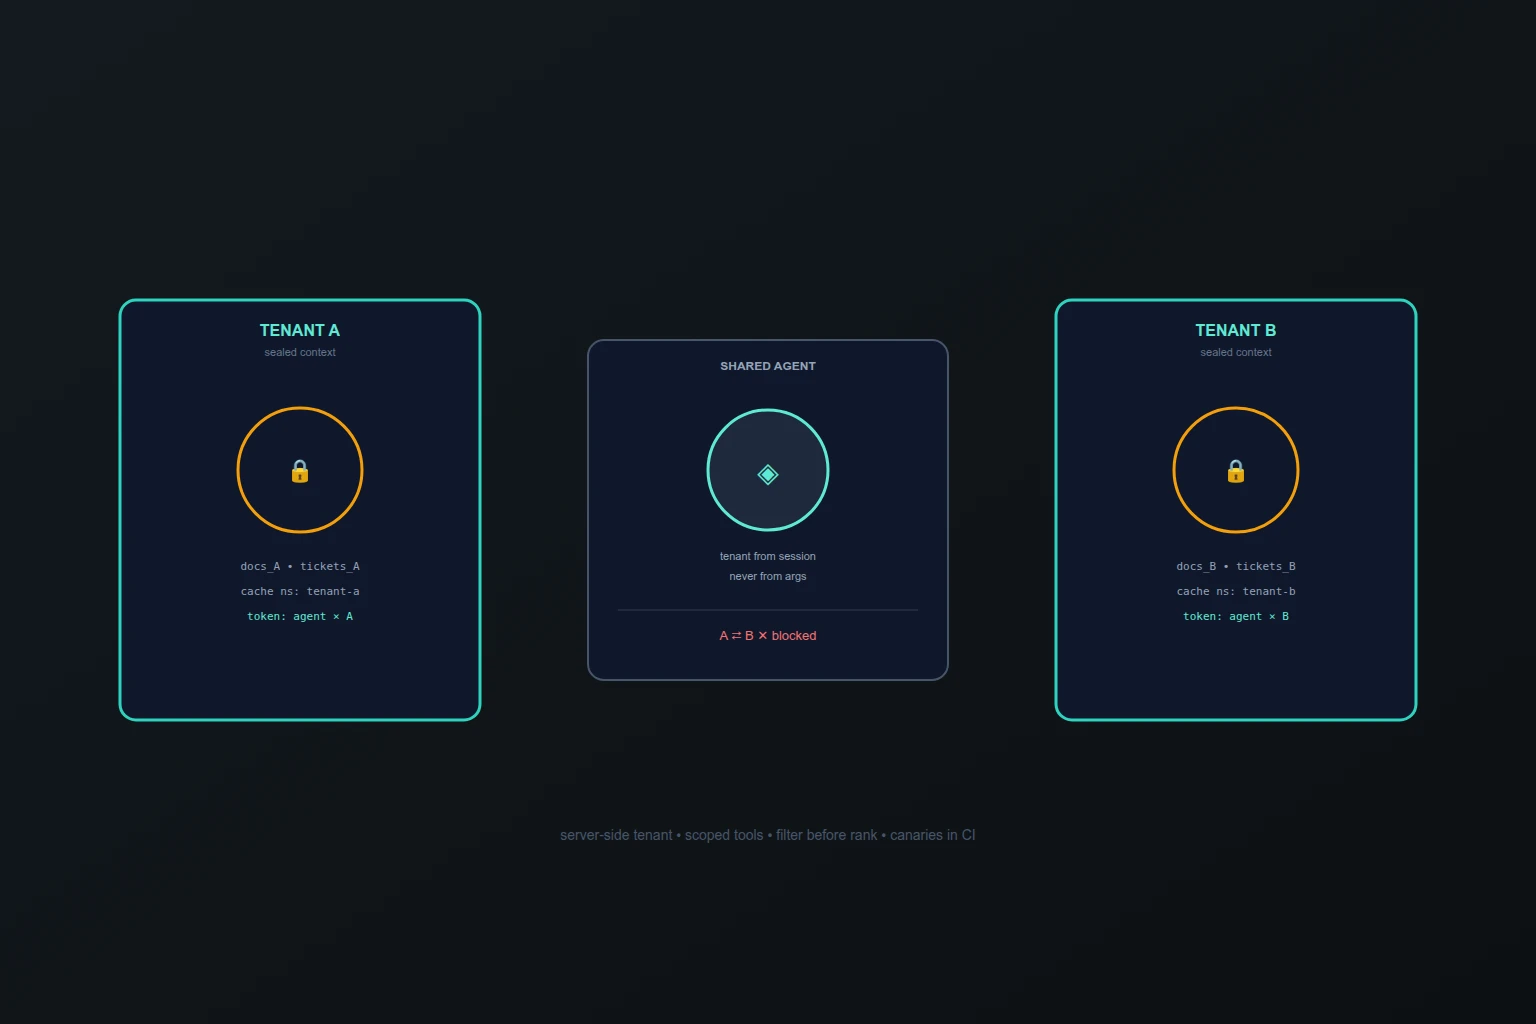
SaaS-компания запускает одного support-агента на всех клиентов: дешевле, чем по агенту на tenant. Архитектура выглядит безобидно — пока одна ошибка в tenant_id не отдаёт в ответ документы соседнего клиента. У обычного API такая ошибка видна в логах запроса; у агента она растворяется в неструктурированном контексте: ретривер вернул чужое, модель пересказала своими словами, и следов «чужого tenant» в ответе уже нет.
Почему общий агент опаснее общего API
API возвращает строки из выборки WHERE tenant_id = X — ошибка видна и воспроизводима. Агент смешивает источники: векторный поиск без tenant-фильтра, кэш диалогов, tool-ответы, few-shot примеры из чужих тикетов. Каждый слой может подмешать чужое, а финальный ответ уже не содержит машиночитаемого указания на источник. Поэтому изоляция строится на каждом слое, а не «проверкой tenant в одном месте».
5 правил изоляции
- Tenant резолвится сервером, а не приходит от агента.
tenant_idизвлекается из аутентифицированной сессии вызывающего, а не из аргументов tool-вызова. Агент не может «попросить» чужой tenant — поле для него read-only. - Инструменты tenant-scoped. Каждый инструмент выполняется в контексте одного tenant: поиск, листинги и выборки всегда с фильтром, bulk-операции через tenant запрещены архитектурно.
- Retrieval с tenant-фильтром до ранжирования. Фильтр по tenant применяется на этапе выборки, а не после rerank: иначе чужой документ с высоким скором вытеснит свой со средним.
- Память и кэш сегментированы. История диалогов, эмбеддинги пользовательских preference и кэш ответов — по namespace на tenant. Общий кэш «частых ответов» допустим только для tenant-нейтрального контента.
- Ответ проверяется перед выдачей. DLP-постпроверка ищет в ответе маркеры чужих tenant (ID, названия, суммы из чужого скоупа) — как последний рубеж, а не основной механизм.
Привязка токенов к tenant
Токен агента привязывается к паре agent × tenant через resource indicators: токен, выданный для tenant A, не принимается инструментами tenant B даже при подмене аргументов. Это закрывает confused deputy, когда скомпрометированный или ошибающийся агент пытается переиспользовать credential в чужом контексте. Ротация — короткоживущие токены, чтобы украденный токен протухал раньше, чем его заметят в чужом скоупе.
Тесты на cross-tenant утечки
- Канарейки: в данные каждого тестового tenant кладётся уникальная метка-фраза; после прогона типовых диалогов проверяется, что метка tenant A никогда не всплывает в сессии tenant B.
- Перепутанный tenant_id: интеграционный тест подменяет tenant в аргументах — сервер обязан проигнорировать его и ответить данными сессионного tenant.
- Отравленный сосед: в tenant A кладётся документ с высокой релевантностью к запросам tenant B — убеждаемся, что фильтр выборки его отсекает.
- Кэш-промывка: одинаковый запрос от двух tenant подряд — второй ответ не должен содержать данных первого.
Эти тесты — в CI-target для агентских изменений, рядом с PII-ловушками.
Что логировать
Каждое действие: agent_id × tenant_id × tool × результат, плюс каким tenant_id резолвилась сессия и был ли конфликт с аргументами. Тогда вопрос «трогал ли агент данные клиента X» закрывается запросом, а попытка подмены tenant видна как аномалия до утечки.
Где Codenik
Codenik резолвит tenant из сессии на каждый tools/call и игнорирует tenant из аргументов агента. Токены привязаны к паре агент × tenant, retrieval и листинги идут с серверным фильтром, а постпроверка режет чужеродные маркеры до попадания в контекст. Один агент обслуживает всех клиентов — изоляцию держит шлюз, а не аккуратность промптов.
Короткий вывод
Общий агент без tenant-изоляции — это общая БД без WHERE: вопрос не «утечёт ли», а «когда заметят». Серверный tenant, scoped-инструменты, фильтр до ранжирования, сегмент памяти и канарейки в CI — пять слоёв, каждый из которых дешёвый по отдельности и дорогой в цене утечки все вместе.