«У нас 99.9% uptime» — говорит команда, чей агент в проде. Звучит надёжно. Проблема в том, что uptime меряет доступность модели, а бизнес волнует другое: правильно ли агент действует. Агент может отвечать всегда, быстро — и регулярно делать terrible decisions: не те вызовы, не те аргументы, не те записи. Традиционные SLA писались под детерминированный софт: тот же запрос — тот же ответ, меряем, что сервис встал и ответил. Агенты ломают допущение: корректность не следует из ответа. Что меняется — что меряем и как enforced. Разберём, как перенести SRE-мышление (SLO, error budgets, circuit breakers) на агентов — с поправкой на недетерминизм.
Почему uptime врёт
Для payments API допущение «ответил — значит правильно» держится: endpoint либо вернул верный баланс, либо упал с ошибкой. Для агента между «ответил» и «правильно» — пропасть: галлюцинация, неполнота, неверная цель, неверный инструмент, правильный инструмент с отравленными аргументами. Поэтому SLI агентов обязаны мерить поведение, а не доступность: goal accuracy (доля ранов, достигших цели), hallucination rate, completeness, topic adherence — каждая через бинарный pass/fail рубрик, проверяемых evidence. Средние скрывают то, во что упираются клиенты при повторах, — поэтому рядом с single-run pass rate отчитывают pass^k (успех в k последовательных прогонах) в разрезе типов задач и сегментов. Так строит отчётность Splunk: офлайн-стандарты eval становятся production-контролями, а траекторная наблюдаемость показывает путь решения, а не только итог.
Арифметика compounding: 76% → 27%
Синтез исследований 2026 года (Zylos) даёт отрезвляющую математику длинных горизонтов: 76% pass@1 на короткой задаче превращаются в 27% на workflow из восьми шагов, если каждый шаг успешен с вероятностью 85%. Компаундинг беспощаден — надёжность системы есть произведение надёжностей шагов минус корреляции отказов. Производственная картина того же года: до продакшена доходят лишь 23% корпоративных агентов, а дошедшие в большинстве выполняют не более 10 шагов до вмешательства человека. И ключевое сравнение режимов: supervised-агенты, автономно закрывающие 90% случаев и эскалирующие 10% человеку, существенно превосходят полностью автономных с точностью 70% — при 90% автономии плюс человеческой коррекции итоговая ошибка по закрытым кейсам близка к нулю. Вывод для SLO: цель «автономность 100%» — антипаттерн; цель — связка «автономная точность + эскалация» с измерением обеих.
Каталог SLI по tiers
Разбор Arvo честно фиксирует: канонического фреймворка error budget для корректности агента нет (статья ноября 2025 года прямо заявляет об отсутствии формализма), вендоры наблюдаемости бюджетят latency, cost и judge-оценки — но не правильность выводов. Практичный каталог SLI сортируется по трудности инструментирования:
Tier 1 — меряется сегодня из существующей телеметрии. Task success rate (pass/fail по рубрикам), tool call success, latency p50/p95/p99 полного цикла агента, cost per task, token budget adherence, iteration count, retry rate, circuit breaker trips. Сюда же safety SLI по Microsoft: доля действий агента в рамках политики (цель — 0.99+).
Tier 2 — требует eval-harness. Goal accuracy на эталонных кейсах, hallucination rate, answer completeness, topic adherence, judge-derived quality scores, pass^k по сегментам (язык, тип документа, бизнес-юнит, риск-уровень). Агрегат, проходящий цель, но валящийся на важных контрактах, — не в допуске: сегментация обязательна.
Tier 3 — исследовательские. Долгосрочная стабильность поведения, устойчивость к дрейфу данных, transfer failure между моделями. Меряем best-effort, в SLO не кладём.
Цели и error budget как правило
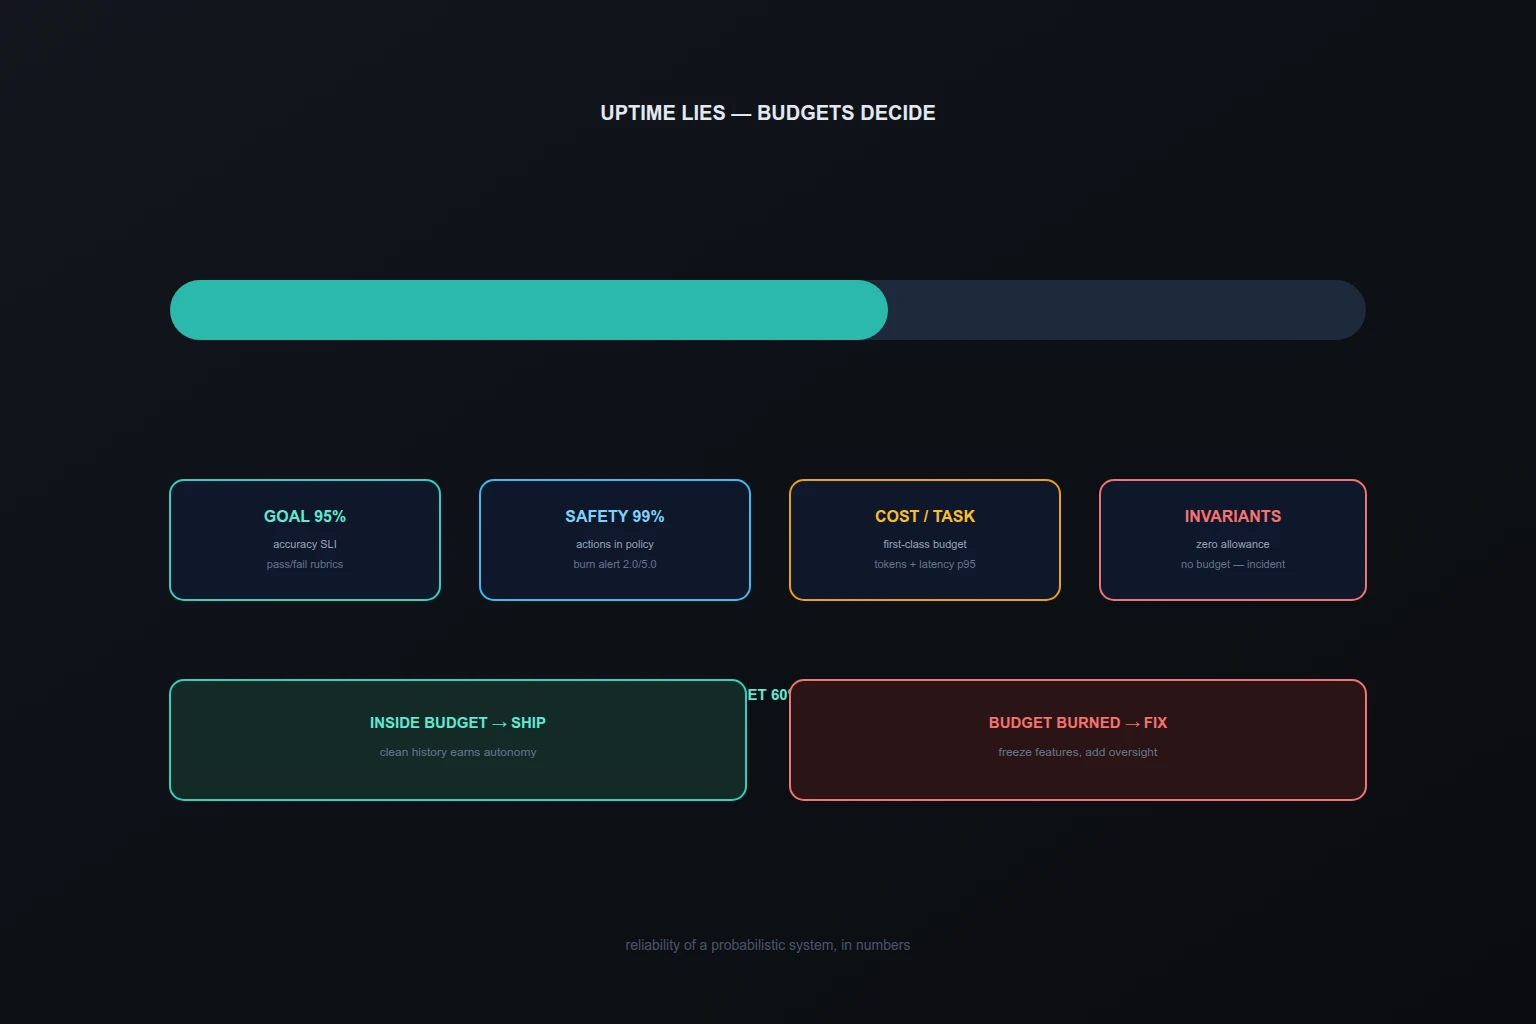
Из SLI цели выводятся естественно: цель точности 95% означает error budget 5% ранов, которым позволено провалиться до нарушения. Бюджет — не метрика, а операционное правило: внутри бюджета — ship изменений; бюджет сгорел — стоп фичам, чиним надёжность. Это даёт продукту и инженерии общее измеримое определение «достаточно надёжно». Бюджеты задаются и на latency (p95 цикла), и на cost per task как первоклассное измерение: агент, укладывающийся в точность, но сжигающий бюджет токенов, — тоже вне SLO.
Burn rate и алерты
Бюджет без скорости сгорания — отчёт задним числом. Практика Microsoft для агентов: burn rate warn на 2.0, page на 5.0; остаток бюджета под 20% — стоп-условие для рискованных релизов. Метрики в существующий стек (Prometheus/OpenTelemetry): safety SLI, burn rate, остаток бюджета. Алерты смотрят не на «агент упал», а на «агент сжигает месячную норму надёжности за день» — классический кейс, когда SLI ещё показывает 99.5%, а 88% бюджета уже нет.
Бюджет управляет автономией
Самая агентная идея из SRE-подхода Microsoft: error budget — не просто метрика, а механизм решений об автономии. Агент с чистой 30-дневной историей безопасности зарабатывает автономию; сжигающий бюджет — теряет её: укорачиваются цепочки, сужаются скоупы, растёт доля human-in-the-loop. Надёжность и скорость изменений связываются автоматически: стабильный агент развивается быстро, нестабильный — под надзором. Это же закрывает спор «давайте дадим агенту больше прав»: права выдаются за измеренную надёжность, а не за доверие.
Hard invariants без бюджета
Важное ограничение от VDF: не всё бюджетируется. Жёсткие инварианты — запрещённый egress данных, запрещённая модель, обход обязательного approval — не получают error budget. Бюджеты — для trade-off надёжности; они не должны нормализовать события, которые организация объявила недопустимыми. Нарушение инварианта — инцидент и стоп, а не «сжигание бюджета». Разделите SLO-документ на две части: бюджетируемое (доступность, latency, recoverable-ошибки) и недопустимое (инварианты с нулевым допуском).
Deployment gate
Самое полезное применение бюджетов — гейт деплоя. Перед продвижением изменения промпта, свапа модели или правки ретрива — перепрогон по датасету известных кейсов с проверкой «влезаем в цели». Не влезли — не едем. Агент с определёнными SLI, enforced SLO и непрерывной оценкой приходит на review готовности с доказательством контроля — и это же доказательство открывает путь к деплою в регулируемых контурах.
Стартовый набор SLO для одного workflow
Начните с одного production-workflow и пяти целей: task success ≥ 95% за 24ч окно; safety SLI (действия в политике) ≥ 99%; latency p95 цикла под лимит сценария; cost per task под бюджет; audit completeness 100% (каждый вызов в журнале — это инвариант, а не цель). Плюс политика бюджета: burn rate алерты 2.0/5.0, остаток < 20% — заморозка рискованных релизов, исчерпание — приоритет надёжности. Через квартал добавьте pass^k и сегментацию по риск-уровням.
Чеклист
- SLI Tier 1 собираются из телеметрии; Tier 2 — из eval-harness; сегментация по риск-уровням.
- Цели заданы числами, бюджеты — операционное правило ship/stop.
- Burn rate алерты 2.0/5.0, остаток бюджета виден команде.
- Автономия привязана к бюджету: чистая история — больше прав, сжигание — надзор.
- Hard invariants вынесены из бюджетов с нулевым допуском.
- Deployment gate: перепрогон эталонов перед каждым продвижением.
- Отчётность pass^k рядом с pass rate, в разрезе типов задач.
- Дата пересмотра целей назначена; триггер — смена модели, инструментов, данных.
Где Codenik
Codenik производит SLI побочно, в процессе работы. Журнал каждого вызова даёт task success, policy compliance и audit completeness из одного источника — без отдельной инструментации. Лимиты цепочек, бюджетов и скоупов — это enforcement error budget на исполнении: бюджет не наблюдается, а действует. Circuit breaker рвет runaway-циклы по счётчику итераций и токенов. Frozen evals регрессируются тем же контуром после каждого изменения — deployment gate из коробки. А проверка инвариантов (нет egress, нет запрещённых инструментов, нет обхода approval) идёт как prevent-контроль, а не как метрика. Надёжность перестаёт быть презентацией — она становится свойством контура с числами, которые можно показать бизнесу.
Короткий вывод
Агенту нужны те же SLO, error budgets и circuit breakers, что и микросервисам, — плюс четыре агентные идеи: мерить поведение, а не uptime; считать компаундинг шагов; привязывать автономию к бюджету; выносить инварианты из бюджетов. Начните с одного workflow и пяти целей — и пусть бюджет решает, когда ship, а когда чинить. «Достаточно надёжно» должно быть числом, а не ощущением.