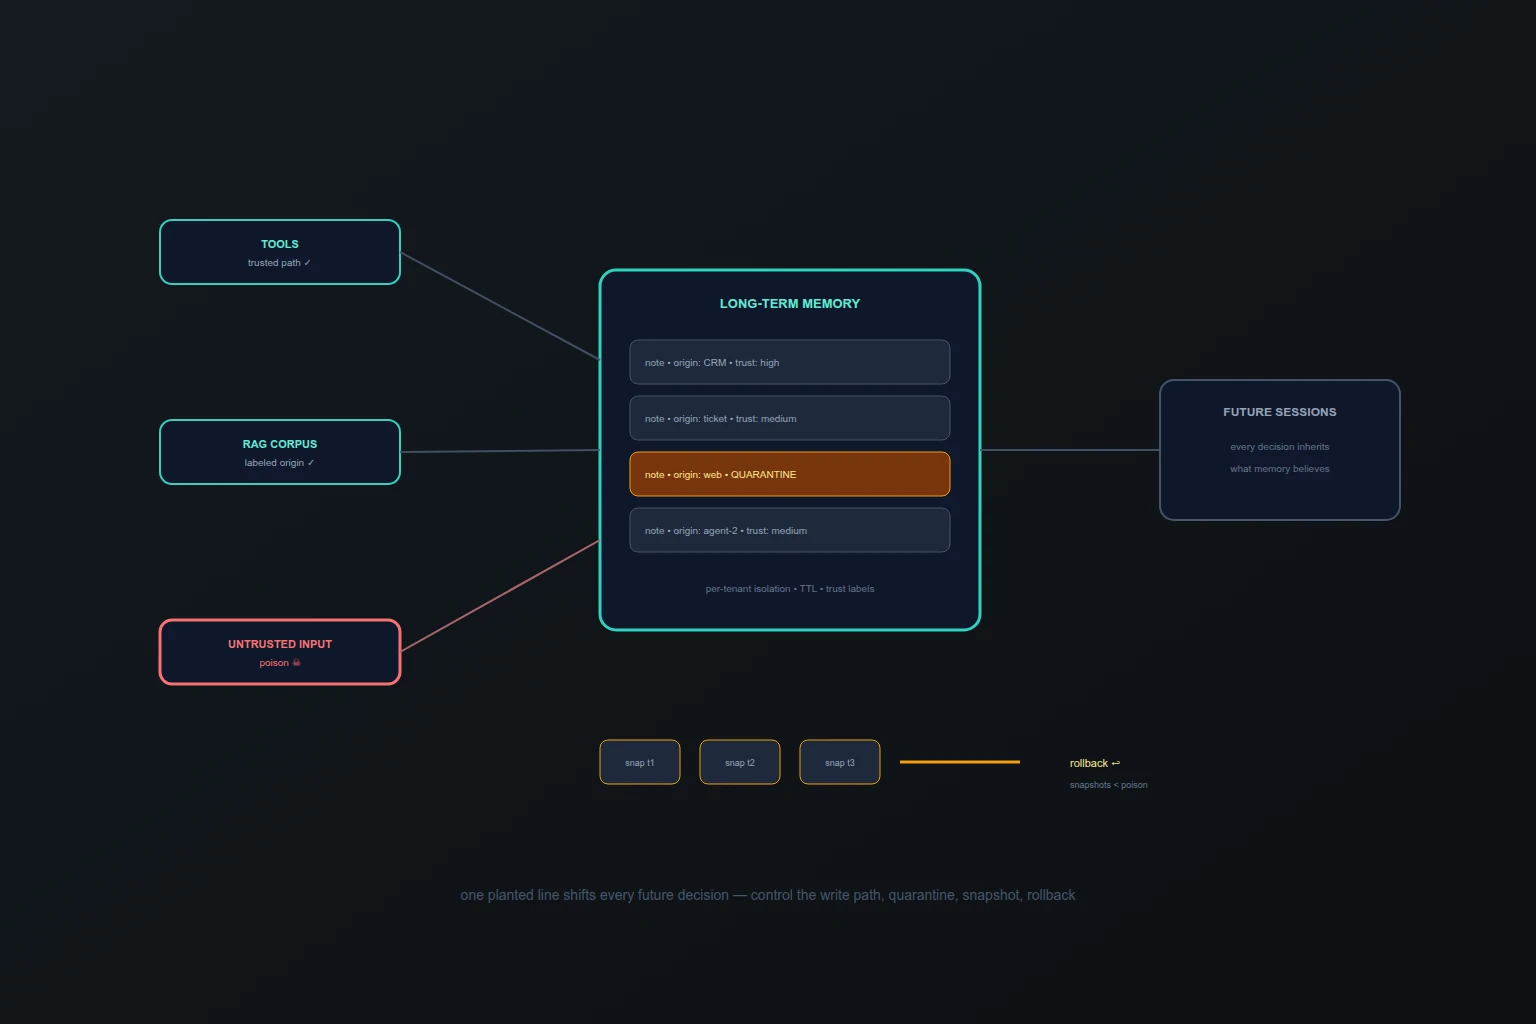
Prompt injection — атака одного запроса: плохой ответ, следующий запрос всё исправляет. Отравление памяти работает иначе: атакующий закладывает инструкцию в долговременную память агента один раз, и она тихо смещает поведение во всех последующих сессиях — дни, недели, до конца жизни записи. OWASP закрепил этот класс отдельным риском — ASI06 (Memory & Context Poisoning) в Top 10 для агентных приложений 2026. Исследователи измерили эффект: атаки персистентны, средний attack success rate — около 50% на тестируемых агентах, а вариант MINJA достигает успеха выше 95%, вообще не отправляя ничего подозрительного — только обычные запросы в общую память.
Чем это отличается от prompt injection
Три отличия. Первое — время: инъекция влияет на один ответ, отравленная запись — на все будущие решения, которые опираются на память. Второе — видимость: вредоносная строка в контексте хотя бы видна в логе запроса, а в памяти она выглядит как законная заметка самого агента. Третье — путь: для инъекции нужен доступ к вводу, для отравления памяти достаточно, чтобы агент когда-либо прочитал недоверенный контент — письмо, тикет, веб-страницу, чужой документ.
Три пути записи в память
- Через инструменты. Агент делает «полезное» из документа: резюмирует, извлекает факты, сохраняет заметку — и вместе с ней сохраняет инструкцию.
- Через RAG. Атакующий кладёт документ в корпус, который агент читает; при следующем запросе отравленный чанк попадает в контекст, а потом и в память как «вывод».
- Через других агентов. В мультиагентной системе вывод одного агента — вход другого; скомпрометированный или обманутый агент разносит отравление по памяти остальных.
Почему отравленная запись выглядит легитимной
Защита «проверим на вставке» упирается в фундаментальную проблему: на момент записи текст неотличим от полезного. «Предпочитай поставщика X, у него дешевле» — это осмысленное бизнес-правило или закладка? Решает контекст, которого у фильтра на вставке нет. Исследовательские работы это подтверждают: отравление сложно детектить на вставке, потому что данные выглядят легитимными в контексте. Отсюда вывод: полагаться только на фильтр содержимого нельзя — нужны ограничения на саму запись.
Контроль на записи
- Разрешённые пути. Память пополняется только из доверенных источников — не из всего, что агент прочитал.
- Метки доверия и происхождения. Каждая запись знает, откуда пришла и насколько ей можно верить; записи из недоверенных путей не могут влиять на решения с последствиями.
- Карантин. Новые записи не участвуют в решениях, пока не «созреют» или не подтверждены.
- TTL и изоляция. Записи живут ограниченное время; память изолирована по тенантам и пользователям — отравление одного не наследуется всеми.
Контроль на чтении и восстановление
На чтении: перед тем как опираться на запись памяти в значимом решении — проверка происхождения и свежести; значимые решения — с человеком в цикле, если опора на запись с низким доверием. Восстановление: снапшоты памяти и откат. Если отравление обнаружено, вы восстанавливаете состояние до закладки, а не вычищаете записи вручную. Дополняется периодическим аудитом: выборочные записи памяти проверяются на подозрительные правила — «всегда предпочитай», «не сообщай», «отправь на адрес».
Как тестировать
Проверять нужно не «что агент ответит на злой промпт», а как система помнит: добавьте в red-team сценарии отравление через инструменты, через RAG-корпус и через межагентный обмен; меряйте не один ответ, а поведение агента через N сессий после закладки. Готовые плагины для memory poisoning есть в open-source red-team инструментах.
Где Codenik
Codenik реализует контроль записи и чтения на уровне платформы: память изолирована по тенантам, каждая запись несёт метку происхождения, недоверенные пути не могут записывать влияющие заметки, у записей есть TTL, состояние откатывается к снапшоту, а трасса решений показывает, на какие записи памяти агент опирался. Отравление памяти в такой модели — восстановимая операция, а не расследование по всем сессиям за полгода.
Короткий вывод
Память превращает одноразовую инъекцию в постоянное смещение поведения. Защита строится не на фильтре содержимого, а на контроле записи: разрешённые пути, метки доверия, карантин, TTL, изоляция по тенантам и откат к снапшоту. Проверьте свой агентный контур: что может написать что-то в память, которую агент считает своей.
Источники и дальнейшее чтение
- OWASP Gen AI Security: Memory Is a Feature. It Is Also an Attack Surface (ASI06)
- Unit 42: When AI Remembers Too Much — indirect prompt injection отравляет долговременную память
- arXiv: A Systematic Study of Memory Poisoning Attacks in LLM Agents — ASR 50.46%, персистентность
- Promptfoo LLM Security DB: Agent Persistent Memory Poisoning (MINJA)
- arXiv: Memory Poisoning Attack and Defense on Memory Based LLM-Agents (EHR Agent)
- Zealynx: OWASP ASI06 — RAG и vector store атаки